Azure OpenAI Serviceは、Azure上でOpenAIのモデルを利用し、自社のアプリケーションや社内システムへ生成AIを組み込めるサービスです。Azureをすでに利用している企業であれば、Microsoft Entra IDによる認証やネットワーク制御、Azure AI Searchなど既存のAzureサービスと組み合わせて生成AI環境を構築できます。
一方、初めてAzure OpenAI Serviceを利用する場合は、「Azure PortalとMicrosoft Foundryのどちらから始めるのか」「以前のような利用申請は必要なのか」「モデルを選んだ後に何を設定すればAPIから呼び出せるのか」など、分かりにくい点があります。
特に現在は、Azure AI FoundryからMicrosoft Foundryへの名称変更、Foundryリソースへの統合、v1 APIへの移行が進んでいます。過去の記事に掲載されている旧画面やAzureOpenAI()クライアント、日付形式 of api-versionを前提としたコードをそのまま利用すると、現在の画面や公式ドキュメントと一致しない場合があります。Microsoftは2026年5月30日にazure-ai-inferenceを終了しており、Assistants APIについても2026年8月26日の終了を案内しています。
また、現在の標準的なAzure OpenAI利用では、以前のようにすべての利用者が事前のLimited Access登録を行う必要はありません。Microsoftによると、登録が必要になるのはLimited Accessに指定されたモデルや、Guardrails・不正利用監視の変更など、対象となるモデル・機能を利用する場合です。
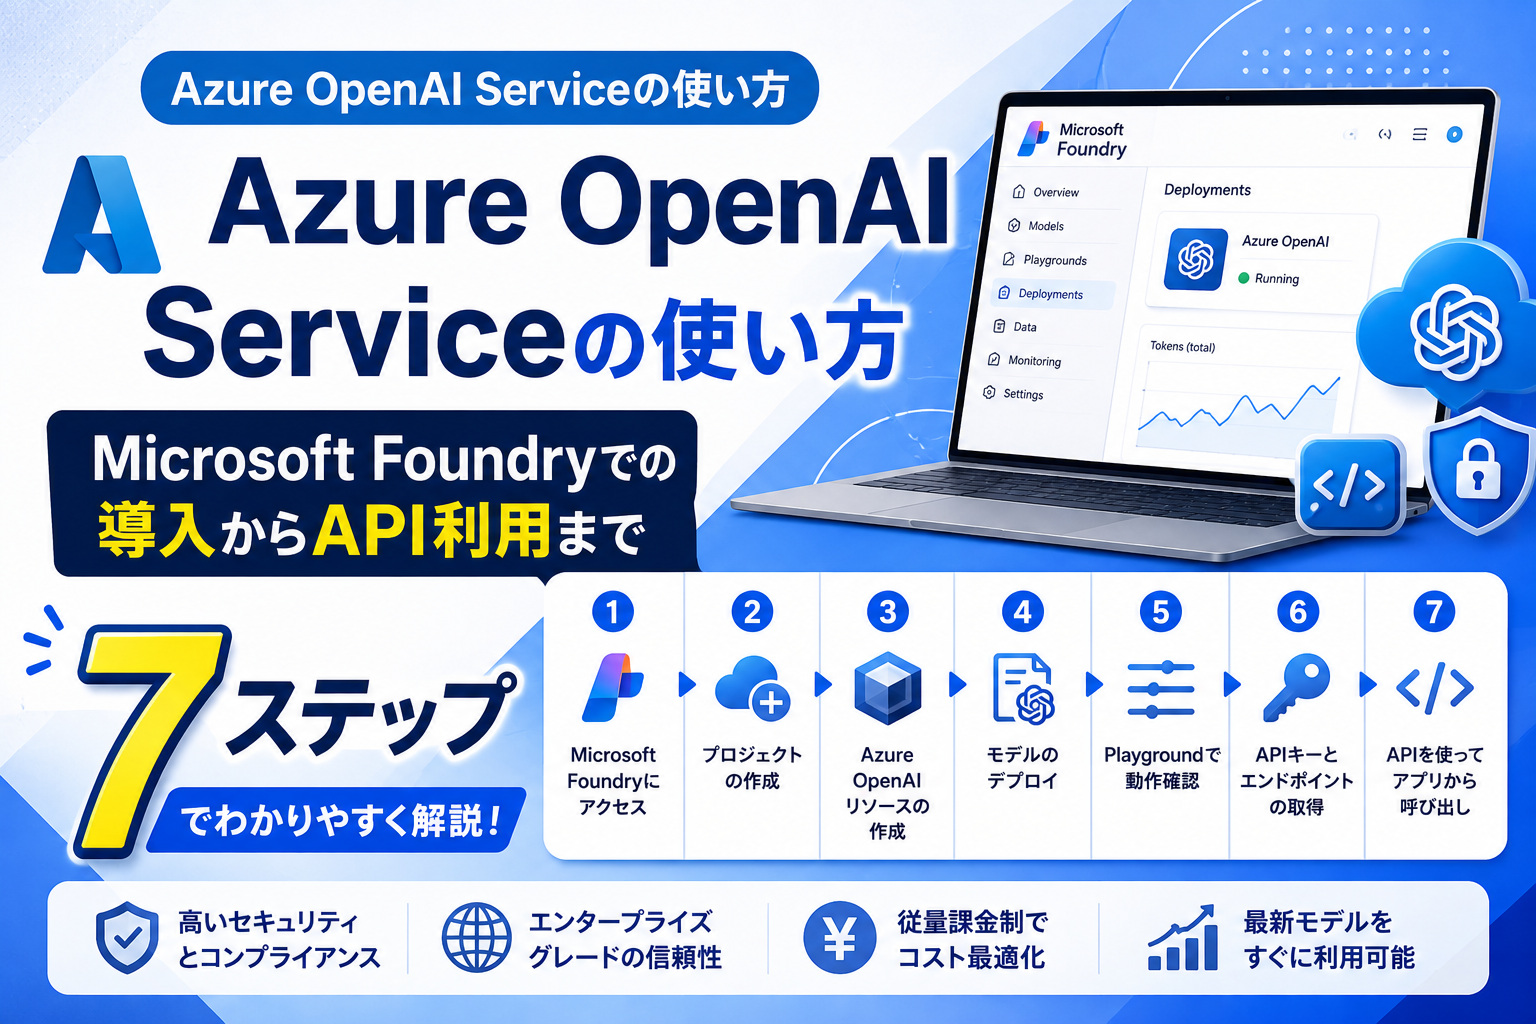
本記事では、Azure OpenAI Serviceの使い方を「Azure環境と権限の準備→Foundryリソース・プロジェクト→モデル選定→デプロイ→Playground→認証→API」の7ステップで解説します。本番環境で重要になるMicrosoft Entra ID、データ処理場所、クオータ、セキュリティ、コスト管理まで整理するため、PoCを始める手順だけでなく、その先の本番導入まで判断する際の参考にしてください。
- Azure OpenAI Serviceの使い方を始める前に押さえるMicrosoft Foundryとの関係
- Azure OpenAI Serviceの使い方|利用開始までの7ステップ
- Azure OpenAI ServiceをPython・APIから使う方法
- Azure OpenAI Serviceのモデル・デプロイ方式の選び方
- Azure OpenAI Serviceのメリットとデメリット
- Azure OpenAI Serviceを企業で使う際のセキュリティ設定
- Azure OpenAI Serviceの企業活用事例3選
- Azure OpenAI Serviceの失敗要因と対策
- Azure OpenAI Serviceの本番導入を判断する基準
- AI導入支援は「フリーコンサルタント.jp」へご相談ください
- まとめ

Azure OpenAI Serviceの使い方を始める前に押さえるMicrosoft Foundryとの関係
Azure OpenAI Serviceの現在の使い方を理解するうえでは、まずMicrosoft Foundryとの関係を整理しておく必要があります。
過去の記事では「Azure OpenAI Service」「Azure AI Studio」「Azure AI Foundry」といった名称が使われていますが、現在はMicrosoft Foundryを中心とした構成へ移行しています。ここでは名称の変遷を追うのではなく、現在どのサービスがどの役割を担うのかを整理します。
Azure OpenAI ServiceとMicrosoft Foundryの現在の関係
Azure OpenAI Serviceが利用できなくなり、別サービスへ完全に置き換えられたわけではありません。Microsoftは、Azure OpenAIリソースとFoundryリソースの両方をサポートしており、既存のAzure OpenAIリソースも引き続き利用できます。
一方、FoundryリソースはAzure OpenAIリソースの機能を包含する、より広い機能を持つリソースとして位置付けられています。Azure OpenAIモデルに加えて幅広いモデルカタログ、Agent Service、評価機能などを扱える点が主な違いです。
既存のAzure OpenAIリソースはFoundryリソースへアップグレードできます。アップグレード後もAzure OpenAIのエンドポイント、APIキー、既存の設定や状態は基本的に維持されます。
2026年には、一部の対象Azure OpenAIリソースについてMicrosoftによるFoundryへの自動アップグレードも段階的に始まっています。対象となった場合はサブスクリプション所有者へ事前通知され、延期やアップグレード後のロールバックも用意されています。そのため、既存利用者は「今すぐすべてを作り直す」のではなく、自社リソースのアップグレード状況と今後使いたいFoundry機能を確認することが重要です。
新規に生成AIアプリケーションを構築する場合は、Microsoft Foundryを起点として「Foundryリソース→プロジェクト→モデル・エージェント・評価」と整理すると、現在のMicrosoft公式情報を追いやすくなります。
Azure OpenAI Service・OpenAI API・Microsoft Copilot Studioの違い
Azure OpenAI Serviceが自社に適しているかは、「生成AIを使いたい」という目的だけでは判断できません。独自アプリへモデルを組み込むのか、ローコードで業務用エージェントを作るのかによって適した選択肢が異なります。
| 比較項目 | Azure OpenAI Service | OpenAI API | Microsoft Copilot Studio |
|---|---|---|---|
| 主な用途 | Azure上の独自アプリへの生成AI実装 | OpenAI APIを直接利用したアプリ開発 | エージェント・業務フローの構築 |
| 開発方法 | API・SDKを中心とした開発 | API・SDKを中心とした開発 | グラフィカル・ローコード中心 |
| モデル制御 | デプロイ・API単位で制御 | OpenAI API仕様に基づき制御 | エージェント・ツール・フロー中心 |
| 認証・権限 | APIキー、Microsoft Entra ID、RBAC | OpenAI側の認証・管理方式 | Microsoft/Power Platform環境の管理 |
| Azure連携 | Entra ID、Key Vault、Monitor、AI Searchなど | Azureを経由せず利用可能 | Microsoft 365やPower Platformとの連携が中心 |
| 運用負荷 | Azureリソース・クオータ等の管理が必要 | API利用環境の管理が必要 | ローコードで始めやすいが環境・エージェント管理が必要 |
| 向いている企業 | Azure基盤へ独自AIアプリを組み込みたい企業 | OpenAI APIを直接使いたい企業 | 業務エージェントを短期間で作りたい企業 |
Azure OpenAI Serviceは、OpenAIモデルをAzureの認証・ネットワーク・リソース管理と組み合わせ、自社アプリケーションからAPIとして利用したい企業に向いています。
Microsoft Copilot Studioは、Microsoftが「グラフィカルなローコードツール」と説明しているように、自然言語や画面操作を中心としてエージェントやワークフローを構築するサービスです。APIレベルでモデル呼び出しを細かく実装するAzure OpenAIとは、開発のアプローチが異なります。
したがって、「Azureを既存基盤として利用している」「独自アプリへ生成AIを組み込みたい」「認証・ネットワークをAzureへ統合したい」という条件が強い企業ほど、Azure OpenAI Serviceが候補になりやすいと整理できます。

社内FAQエージェントを短期間で作りたい場合と、自社サービスのバックエンドへ生成AIを組み込みたい場合では、適したサービスが異なります。最初に「何を作るか」を決めてから製品を選ぶことが重要です。
Azure OpenAI Serviceの使い方|利用開始までの7ステップ
Azure OpenAI Serviceを初めて利用する場合は、先にモデルだけを選ぶのではなく、Azure環境と権限、リソース、モデル・リージョン・クオータ、認証を順番に確認することが重要です。
ここでは、初回のAPI実行までを7ステップに分けて解説します。
ステップ1|Azureサブスクリプションと必要権限の確認
最初に、有効なAzureサブスクリプションと、自分に付与されている権限を確認します。
Foundryでは、「Azureリソースを作成・管理する権限」と「作成済みのFoundry環境でモデルや各機能を利用する権限」が分かれています。
Microsoftの現行RBAC資料では、AzureのOwnerやContributorはFoundryリソースやプロジェクトの作成・管理が可能です。一方、これらのAzureロールだけではFoundry上での開発に必要なデータ操作権限をすべて持つわけではありません。開発者にはFoundry Userなど、用途に応じたデータ操作権限を追加します。
PoC開始前には、少なくとも次の3点を確認します。
- 利用するAzureサブスクリプションが決まっているか
- リソース・プロジェクトを作成する担当者の管理権限があるか
- モデルを利用する開発者・アプリケーションの権限を分けて設計できているか
本番環境では、モデルを利用するだけの担当者へ一律にContributorを付与する必要はありません。「環境を管理する人」と「モデルを利用する人」を分けることが最小権限設計の基本です。
なお、標準的なAzure OpenAI利用ではLimited Access登録を前提にする必要はありません。利用予定のモデルやGuardrails設定がLimited Accessの対象である場合のみ、追加条件を確認します。
ステップ2|Microsoft Foundryリソースとプロジェクトの作成
次にMicrosoft Foundryへアクセスし、モデルを利用するための環境を作成します。
現在のFoundryでは、プロジェクトを作成すると、その基盤となるFoundryリソースを新規作成するか既存リソースを利用できます。作成時にはAzureサブスクリプション、リソースグループ、リージョンなどを指定します。
役割は次のように整理すると理解しやすくなります。
- Azureサブスクリプション:Azure全体の契約・課金単位
- リソースグループ:関連するAzureリソースをまとめる管理単位
- Foundryリソース:モデル利用、セキュリティ、各種Foundry機能の基盤
- プロジェクト:アプリケーションやチームごとにAI開発を管理する単位
- モデルデプロイ:実際にアプリケーションから呼び出すモデル環境
既存のAzure OpenAIリソースを持つ企業は、新しい環境をゼロから作り直す必要はありません。既存環境を継続利用するかFoundryへアップグレードするかを、必要な機能と移行計画から判断します。
ステップ3|用途に合うモデル・リージョン・デプロイ方式の選定
Foundry環境を作成したら、次に利用するモデルを決めます。
ここで重要なのは、モデル名だけで決めないことです。同じモデルでも、利用可能なリージョンやデプロイ方式、クオータは異なります。
選定は次の順番で進めます。
- 業務用途の定義
- 必要な精度・入力形式を満たすモデル候補の選定
- 利用可能なデプロイ方式の確認
- リージョン・データ処理場所の確認
- 必要なクオータの確認
たとえば、社内文書の短い分類と、複数資料を読み込ませた複雑な推論では必要なモデル性能が異なります。画像を入力するのであれば、画像入力への対応も必要です。
また、モデル提供状況は継続的に変更されます。Microsoftも、本番導入前にはモデルと機能のリージョン別提供状況、クオータを個別に確認するよう案内しています。
Global、Data Zone、Regionalでは、推論処理を行える地理的範囲にも違いがあります。2026年8月時点のMicrosoftのモデル提供資料では、Data Zoneには米国・EUに加えてAPACを対象とする提供形態も確認できます。ただし対応モデル・デプロイ方式・リージョンは変動するため、利用時点のモデルカタログで確認が必要です。
ステップ4|モデルデプロイとTPMクオータの割り当て
Azure OpenAI Serviceでは、モデルカタログでモデルを見つけただけではAPIから利用できません。対象モデルを選び、実際に呼び出すためのデプロイを作成します。
デプロイ時には、主に次の項目を確認します。
- モデルとバージョン
- デプロイ名
- デプロイ方式
- 割り当てる処理容量
特に注意したいのがデプロイ名です。Azure OpenAIのAPIでは、modelパラメータへ実際のデプロイ名を指定する構成があります。モデル名とデプロイ名を同じにする必要はないため、複数環境を管理する企業では命名規則を決めておくと管理しやすくなります。
もう1つ重要なのがクオータです。
TPMはTokens Per Minuteの略で、1分間に処理できるトークン量に関するレート制限です。RPMはRequests Per Minuteで、1分間のリクエスト数に関係します。
Microsoftによると、デプロイへTPMを割り当てることでTPMとRPMのレート制限が設定されます。また、レート制限の判定に使用する推定トークン数と、実際の料金計算に使われるトークン数は同じものではありません。
希望する容量を割り当てられない場合は、次の順番で確認します。
- サブスクリプション側の利用可能クオータ
- 対象モデル
- デプロイ方式
- リージョン
- 別モデル・別リージョンの候補
ステップ5|Playgroundでのプロンプト・応答検証
モデルをデプロイしたら、すぐにアプリケーションコードを書くのではなく、まずFoundryのPlaygroundで動作を確認します。
Playgroundを先に使う理由は、問題が「モデルやプロンプトにあるのか」「API実装にあるのか」を分離できるためです。
代表的な業務入力を用意し、少なくとも次の項目を確認します。
- 必要な情報を正しく抽出・生成できるか
- 指示した出力形式に従えるか
- 日本語の品質に問題がないか
- 長文を入力した場合にも期待する結果になるか
- 応答速度が業務上許容できるか
- Guardrailsによる拒否・フィルタリングが業務へ影響しないか
「回答が返った」ことと「業務で使える」ことは別です。本番で実際に入力するデータに近い複数のテストケースを用意し、同じ条件でモデルを比較します。
| 評価項目 | 入力例 | 期待結果 | 実際の結果 | 合否 | 備考 |
|---|---|---|---|---|---|
| 正確性 | 実業務の代表質問 | 必須情報を正確に回答 | PoCで記録 | ○/△/× | 誤りの種類も記録 |
| 指示追従 | 指定フォーマットで出力 | 形式を維持 | PoCで記録 | ○/△/× | JSON等も必要に応じ確認 |
| 日本語品質 | 社内文書の要約 | 自然な業務日本語 | PoCで記録 | ○/△/× | 用語・敬語も確認 |
| 応答速度 | 標準入力 | 業務上の許容時間内 | 秒数を記録 | ○/△/× | 平均だけでなくばらつきも確認 |
| 長文処理 | 長い資料・規程 | 重要情報を維持 | PoCで記録 | ○/△/× | 入力token量も記録 |
| Guardrails | 境界ケース | 社内ポリシーに合う挙動 | PoCで記録 | ○/△/× | 過剰拒否も確認 |
モデルAとモデルBを比較するときに質問文まで変えてしまうと、モデル差なのかプロンプト差なのか判断しにくくなります。同じ評価データを使うのが基本です。
ステップ6|エンドポイントと認証方式の設定
Playgroundで動作を確認できたら、アプリケーションから接続するためのエンドポイントと認証方法を設定します。
PoCではAPIキーを使うと少ない設定で動作確認できます。一方、APIキーは「キーを知っている主体」がアクセスできる仕組みのため、漏えい時の影響やローテーション管理を考慮する必要があります。
Microsoftは多くのシナリオでMicrosoft Entra IDによる認証を推奨しています。Microsoft Entra IDを使うと、RBACによって利用主体ごとに権限を設定でき、Azure上で動作するアプリケーションではマネージドIDを利用して認証用シークレット自体を持たない設計も可能です。
| 比較項目 | APIキー | Microsoft Entra ID |
|---|---|---|
| 初期設定 | 比較的簡単 | RBAC・ID設定が必要 |
| 秘密情報 | キーを安全に保管する必要あり | マネージドIDなら固定シークレットを減らせる |
| ローテーション | キー交換の管理が必要 | AzureのID管理へ統合しやすい |
| RBAC | キー単体では細かな主体別制御が難しい | IDごとに最小権限を設定可能 |
| PoC | 利用しやすい | 利用可能 |
| 本番利用 | 管理策を講じて利用 | 原則として優先的に検討 |
APIキーを利用する場合も、Pythonコードへ直接書き込むのは避けます。環境変数やAzure Key Vaultなどを利用し、Gitリポジトリや共有チャットへキーが残らないようにします。
ステップ7|v1 API・OpenAI SDKによるモデル呼び出し
最後に、Pythonなどのアプリケーションからデプロイ済みモデルを呼び出します。
現在のAzure OpenAI v1 APIでは、従来のAzure OpenAI向けコードから重要な変更があります。Microsoftの現行ドキュメントでは、Pythonの場合、標準のopenaiパッケージとOpenAI()クライアントを使用します。
主な違いは次の通りです。
AzureOpenAI()ではなくOpenAI()クライアントを利用- エンドポイント末尾に
/openai/v1/を指定 - 安定版v1では日付形式の
api-version指定が必須ではない modelには利用するモデルデプロイ名を指定
旧記事でAzureOpenAI()、api_version=”2024-…”、azure-ai-inferenceなどが掲載されている場合は、記事の公開・更新時期と利用APIを確認してください。新規開発であれば、現在のv1 APIと標準OpenAI SDKを基準にすることが重要です。
Azure OpenAI ServiceをPython・APIから使う方法
初回のAPI接続では、認証方式と利用するAPIを分けて考えると整理しやすくなります。
PoCではAPIキーで接続経路を単純化し、本番化に向けてMicrosoft Entra ID・マネージドIDへ移行する方法が現実的です。また、新規開発ではResponses APIも選択肢に入ります。
PoCでのAPIキーによる最小構成の確認
PoCの最初の目的は、Azure OpenAIのデプロイへアプリケーションから正常にアクセスできることを確認することです。
Pythonではopenaiパッケージを導入し、先ほどの例のようにAPIキーとv1エンドポイントを環境変数から読み込みます。
設定値は大きく3つです。
- APIの接続先となるv1エンドポイント
- 認証に使うAPIキー
- Foundryで作成したモデルデプロイ名
モデル名とデプロイ名を混同すると、モデルをデプロイできていてもAPI呼び出しが失敗する原因になります。Foundry上のデプロイ設定とコード上のmodelパラメータを対応させて管理することが重要です。
動作確認が終わったら、APIキーをソースコード、Gitリポジトリ、Wiki、チャットへ残さないようにします。
本番環境におけるMicrosoft Entra IDとマネージドID
本番環境では、Microsoft Entra IDを利用することで認証をAzureのID管理へ統合できます。
ローカル開発ではDefaultAzureCredentialを利用し、Azure上のApp Service、Functions、Container AppsなどではマネージドIDを使う構成が候補になります。
Microsoftのv1 APIの公式例では、Pythonから次のようにトークンプロバイダーを作成できます。
from openai import OpenAI
from azure.identity import DefaultAzureCredential, get_bearer_token_provider

token_provider = get_bearer_token_provider(
    DefaultAzureCredential(), "https://ai.azure.com/.default"
)

client = OpenAI(
    base_url="https://<リソース名>.openai.azure.com/openai/v1/",
    api_key=token_provider
)

response = client.responses.create(
    model="<デプロイ名>",
    input="社内規程を要約してください。"
)

print(response.output_text)
Azure上のアプリケーションへマネージドIDを付与すれば、APIキーのような長期的なシークレットをアプリ側で保存・ローテーションする必要を減らせます。
さらにRBACで、「モデルを呼び出せる主体」「リソースを管理できる主体」を分けます。
Chat CompletionsとResponses APIの使い分け
Azure OpenAIのv1 APIでは、既存のChat Completionsに加えてResponses APIを利用できます。
Chat Completionsは、チャット形式のモデル呼び出しを中心とした既存アプリケーションとの互換性を重視する場合に利用できます。
一方、MicrosoftはAzure OpenAIモデルについてResponses APIを推奨しており、Responses APIはテキスト生成だけでなく、複数ターンの状態管理やツール利用などを統合して扱えるインターフェースです。
選び方は次のように整理できます。
- 既存のChat Completions実装を維持したい:Chat Completions
- 新規にシンプルなモデル呼び出しを作る:Responses APIも含めて比較
- ツール利用・エージェント型処理へ拡張する:Responses APIを優先的に検討
なお、旧Assistants APIは2026年8月26日に終了予定です。新規システムでAssistants APIを前提とした古い記事をそのまま採用するのは避け、Responses APIや現在のFoundry Agent Serviceを確認してください。
PoCでは「今動くAPI」だけでなく、本番化する時点で継続利用できるAPIかも確認しておくと、大きな作り直しを防ぎやすくなります。
Azure OpenAI Serviceのモデル・デプロイ方式の選び方
Azure OpenAI Serviceのモデル選定では、「最も性能が高いモデル」を選ぶことが必ずしも最適ではありません。
企業では、精度・速度・コストに加え、モデルをどこで処理できるか、必要な処理量を確保できるかまで含めて判断します。
精度・速度・入力形式・コストによるモデル選定
モデル選定では、最初に業務要件を定義します。
たとえば、次のような違いがあります。
- 文章の分類・整形
- 短い要約
- 複雑な推論
- 画像を含む文書の理解
- 大量テキストの処理
すべてを同じ高性能モデルへ任せるのではなく、軽量な処理は低コスト・高速なモデル、判断が難しい処理だけ高性能モデルへ振り分ける構成も候補になります。
比較する際は、一般公開されているベンチマークだけでなく、自社の実データに近い評価セットを利用します。「正答率」「担当者の合格率」「応答時間」「1件あたりトークン量」などを同じ条件で測定してください。
モデル提供状況は更新されるため、特定モデルを記事上で「常に最適」と固定するのではなく、利用時点のFoundryモデルカタログとリージョン提供状況を確認することが重要です。
Global・Data Zone・Regionalの処理場所と可用性
デプロイ方式を選ぶ際は、Azureリソースを作成した場所と、AIによる推論処理が行われる場所を同じものとして扱わないことが重要です。
| 項目 | Global | Data Zone | Regional |
|---|---|---|---|
| 推論処理の範囲 | 対象モデルを提供するAzureの複数地域へルーティングされる可能性 | Microsoftが定義する特定データゾーン内 | 指定したAzureリージョン |
| モデル・容量 | 選択肢を確保しやすい | Globalより処理範囲を制約 | 利用可能モデル・容量が限定される場合あり |
| データ所在地要件 | 厳格な単一地域要件では要確認 | ゾーン単位の要件に適合する場合の候補 | 特定リージョン要件がある場合の候補 |
| 主な用途 | 可用性・モデル選択肢を重視 | 処理地域と可用性のバランス | 厳格な地域要件 |
| 確認事項 | 推論処理場所 | 利用可能なData Zoneとモデル | 対象リージョンのモデル・クオータ |
Global系はAzureのグローバルインフラを利用してリクエストをルーティングできるため、モデルや容量の選択肢を確保しやすい一方、推論処理がリソースを作成したリージョンだけで行われるとは限りません。
Data Zoneは、指定されたデータゾーンの範囲内で処理する方式です。
Regionalは、特定のAzureリージョン内で処理する要件がある場合の候補です。
一方、保存データについては別の考え方があります。Microsoftは、GlobalやData Zoneを利用する場合でも、保存されるデータは顧客が指定したAzure geographyに保存されると説明しています。
「データが保存される場所」と「推論時に処理される場所」を分けて確認することが、法務・情報セキュリティ審査で重要になります。
Standard・Provisioned・Batchの負荷特性と予算
処理場所とは別に、処理量と料金の特性からStandard、Provisioned、Batchを選びます。
Standard系は、入力・出力トークンなどの実利用量に応じて支払う方式です。PoCや利用量が変動するオンライン処理では、最初の候補にしやすい方式です。
Provisioned Throughputは、PTU(Provisioned Throughput Unit)によって一定の処理能力を確保する考え方です。継続的に高い負荷が発生し、安定したスループットやレイテンシが重要な本番ワークロードで検討します。Microsoftは、Provisionedでは容量計算ツールなどを使ったサイジング方法を提供しています。
Batchは、大量の処理を非同期でまとめて実行する方式です。MicrosoftはGlobal Batchについて、24時間の処理目標とGlobal Standard比50%低い価格を案内しています。リアルタイム性が必要ない大量文書の要約、分類、夜間バッチなどが候補です。
整理すると、次のようになります。
- PoC・変動するオンライン利用:Standard系
- 継続的な大規模オンライン処理:Provisioned
- 即時応答が不要な大量処理:Batch
料金はモデルやデプロイ方式によって更新されるため、固定単価を記事だけで判断せず、公開時点のAzure公式料金ページで確認してください。
Azure OpenAI Serviceのメリットとデメリット
Azure OpenAI Serviceの強みは、単にOpenAIモデルを利用できることではありません。Azureの企業向け認証・ネットワーク・監視基盤へ生成AIを組み込みやすい点にあります。
その反面、Azure固有のリソース、権限、リージョン、クオータを設計する必要があり、直接APIを利用する場合より管理項目が増えます。
Azure基盤の認証・ネットワーク・監査との統合
企業がAzure OpenAIを選ぶ主なメリットとして、Microsoft Entra IDとRBACによるアクセス制御があります。
APIキーを共有するのではなく、人やアプリケーションのIDを基準に「誰がモデルを利用できるか」を管理できます。
また、要件に応じてPrivate Endpointなどを利用したネットワーク分離も検討できます。現在のMicrosoft Foundryでは、受信アクセス、Foundryから他サービスへの送信、Agent関連の通信などを分けてネットワーク分離を設計できます。
Azure Monitor、Key Vault、Azure AI Searchなど既存のAzureサービスと組み合わせやすいことも、Azureを標準基盤としている企業にとって利点です。
さらに、MicrosoftはAzure OpenAIを含むModels sold by Azureについて、顧客のプロンプト、生成結果、埋め込み、学習データをOpenAIなど他のモデル提供者へ提供せず、顧客の許可・指示なしに生成AI基盤モデルの学習へ利用しないと説明しています。
Azureの既存ガバナンスへ生成AIを組み込みやすいことが、法人利用におけるAzure OpenAIの大きな特徴です。
設定・クオータ・仕様変更への継続対応
デメリットは、Azure固有の設計・運用項目が増えることです。
Azure OpenAIを利用する場合は、モデルのAPI利用だけでなく、Azureリソース、RBAC、ネットワーク、リージョン、デプロイ方式、クオータなどを管理する必要があります。
また、希望するモデルを希望する条件で必ず利用できるわけではありません。モデルごとに利用可能なリージョン、デプロイ方式、容量が異なります。
Microsoft Foundryへの統合やv1 APIなど、仕様更新も継続しています。過去に作成した手順書やサンプルコードを固定したまま使い続けず、公式ドキュメントの更新を追う体制が必要です。
小規模な個人検証だけであれば、Azure側の設計・運用が相対的に重くなる場合があります。そのため、Azureを利用している企業であっても、自動的にAzure OpenAIが最適になるわけではありません。
Azure OpenAI Serviceを企業で使う際のセキュリティ設定
企業利用では、「Azure OpenAIは安全か」という一つの問いではなく、データ、認証、ネットワーク、生成内容の4つに分けて確認する必要があります。
PoC段階から本番環境を想定して設計しておくことで、本番直前のセキュリティレビューによる大幅な作り直しを減らせます。
入力データと生成データの取り扱い
Microsoftは、Azure OpenAIを含むModels sold by Azureへ送信されたプロンプトや生成結果について、他の顧客やOpenAIなどのモデル提供者へ提供せず、許可なく生成AI基盤モデルの学習へ利用しないと説明しています。
ただし、ここから「Azure OpenAIではデータが一切保存されない」と結論付けるのは適切ではありません。
Microsoftの現行資料では、Responses API、Assistants APIのThreads、Stored completionsなど、一部のステートフルな機能ではメッセージ履歴などのデータを保存すると説明されています。Responses APIも、利用方法によってメッセージ履歴などを保持する機能があります。
そのため、自社ではデータを次のように分類します。
- 公開情報:原則入力可能
- 社内限定情報:利用環境・ログ設定を確認して判断
- 個人情報・顧客情報:社内規程と利用目的に基づき判断
- 営業秘密・高度機密情報:個別審査または入力禁止
Azure OpenAI側だけでなく、自社アプリケーションのログ、データベース、監視基盤にプロンプトや出力が残る可能性も確認してください。
Microsoft Entra IDを中心とした認証・権限管理
本番環境では、人やアプリケーションごとにMicrosoft Entra IDで認証し、RBACで必要な操作のみを許可する構成を基本とします。
Azure上で動作するアプリケーションではマネージドIDを利用することで、長期間有効なAPIキーをアプリケーション内へ保存する必要を減らせます。
APIキーを残す必要がある場合は、コードや設定ファイルへ直接記載せず、Key Vaultなどの秘密情報管理サービスを利用します。
また、開発、検証、本番を分離し、PoCで使った権限をそのまま本番へ持ち込まないことも重要です。
PoCの「とりあえず動かすための権限」が、そのまま本番の標準設定にならないように注意してください。
ネットワークとGuardrailsによる4層の対策
認証だけでAzure OpenAIのセキュリティ対策が完了するわけではありません。
企業では、次の4層で確認すると整理しやすくなります。
- 通信経路:Public Network Access、Private Endpoint、VNetなど
- 認証・認可:Microsoft Entra ID、マネージドID、RBAC
- 入力データ:入力可能な情報区分、保存・ログ
- 生成内容:Guardrails、コンテンツフィルター、業務側レビュー
Microsoft Foundryでは、Private Endpointを利用してFoundryリソースへのアクセスを制限できます。セキュリティ要件が高い環境では、Azure AI SearchやStorageなど接続先についてもPrivate Endpointを個別に検討する必要があります。
また、Azure OpenAIのモデルには既定のGuardrails・コンテンツフィルターがあります。入力と出力を検査し、不適切なコンテンツを検出・制御します。フィルターを完全に無効化するなど一部の変更にはLimited Accessの承認が必要です。
Azure OpenAI Serviceの企業活用事例3選
Azure OpenAI ServiceのPoCテーマを選ぶ際は、「生成AIを使うこと」を目的にするのではなく、現在時間がかかっている業務や繰り返し作業を起点にすると効果を測りやすくなります。
ここではMicrosoftが公開している国内企業3社の事例から、Azure OpenAIの使い方と測定している成果を整理します。
【通信】KDDI|営業資料の情報収集時間を約74%削減
KDDIでは、法人営業における資料作成のための情報収集・整理に多くの時間がかかっていました。
そこで、過去の営業資料をAzureへ取り込み、Azure OpenAIによる要約や検索プロンプト補完、Azure AI Searchによる検索を組み合わせたシステムを構築しています。
Microsoftの顧客事例によると、アンケートでは80%のユーザーが情報収集時間の削減を実感し、1ユーザーあたり平均約74%の削減が確認されています。
この事例から分かるのは、生成AIの回答精度だけをKPIにするのではなく、「情報を探す時間」のように導入前から発生している業務時間を測ることの重要性です。
社内文書検索やRAGをPoCにする場合は、検索時間、必要資料への到達率、回答後の確認時間などをKPIにすると効果を比較しやすくなります。
【IT・SaaS】LayerX|年間570時間の文書処理削減見込み
LayerXは、文書処理プラットフォーム「Ai Workforce」をMicrosoft Azure上に構築しています。
構成にはAzure OpenAI in Foundry Modelsのほか、Azure AI Search、Azure Container Apps、Azure Cosmos DBなどが利用されています。文書の抽出、検索、生成AI処理を単独サービスで完結させず、複数のAzureサービスを組み合わせている点が特徴です。
Microsoftの顧客事例では、Ai Workforceを利用する三井物産クレジットコンサルティングが年間570時間の労働時間削減を見込んでいると紹介されています。「570時間をすでに削減した」と断定するのではなく、一次情報に合わせて削減見込みとして捉える必要があります。
文書処理のPoCでは、生成された文章の品質だけでなく、「読み込み→情報抽出→確認→転記」のうち、どの工程を何時間削減できるかまで測定すると投資効果を説明しやすくなります。
【通信】ソフトバンク|30~50%のプレゼンテーションを10分未満で作成
ソフトバンクでは、Azure OpenAIを活用した「satto workspace」により、情報収集や資料作成を支援しています。
利用者が必要な内容を指定すると、リサーチ、コンテンツ生成、フォーマットまでを支援し、その後の対話によって内容を修正できる仕組みです。
Microsoftが2026年4月に公開した顧客事例では、プレゼンテーションの30~50%が10分未満で作成されていると紹介されています。
この事例から、PoCの候補を「AIへ質問する業務」だけに限定する必要はないことが分かります。情報収集、構成、文章生成、整形のように一定の手順を繰り返す業務は、前後の作業時間を測りやすく、生成AI導入の効果を定量化しやすい領域です。
Azure OpenAI Serviceの失敗要因と対策
Azure OpenAI ServiceはPlaygroundで回答を出すところまでは比較的短期間で進められます。一方、本番利用ではAPI、リージョン、クオータ、セキュリティ、コストの設計不足が問題になりやすくなります。
ここでは、導入時に起こりやすい5つの失敗を「症状→原因→実害→対策」の順で整理します。
旧手順参照による画面・SDKの不一致
典型的な症状は、「記事に掲載されているメニューが見つからない」「Azure OpenAIの利用申請画面を探し続ける」「サンプルコードのapi_versionやクライアントが現在のMicrosoft公式コードと違う」といった状態です。
原因は、Microsoft Foundryへの統合とAPI・SDKの更新が続いている一方、検索結果にはAzure AI Foundryや旧Azure OpenAIを前提とする記事が残っていることです。
そのまま実装すると、動作しないコードの調査に時間を使ったり、終了予定のAPIを新規システムへ採用したりする可能性があります。
対策として、外部記事を見る際は次の4項目を確認します。
- 利用しているポータル名
- SDK・Pythonパッケージ
- APIバージョン
- 記事・公式ドキュメントの更新日
新規実装ではv1 APIと現行のopenaiパッケージを基準にし、旧方式を利用する場合は既存システムとの互換性など明確な理由を持たせます。
モデル・リージョン・クオータの後確認によるデプロイ失敗
モデル名を先に決めて環境構築を進めた結果、「希望リージョンでは利用できない」「必要なデプロイ方式に対応していない」「本番想定のTPMを確保できない」と判明するケースがあります。
原因は、モデル、デプロイ方式、リージョン、クオータがそれぞれ独立した条件ではなく、組み合わせによって利用可否が変わることです。
対策は、PoCを開始する前にモデル→デプロイ方式→リージョン→クオータ→データ処理場所の順で確認することです。第1候補が利用できない場合の第2候補も決めておくと、PoC日程への影響を抑えやすくなります。
本番移行前には、少人数の手動検証だけではなく、想定同時利用数で負荷試験を行います。
APIキーのコード埋め込みによる認証情報漏えい
PoCを急ぐと、APIキーをPythonファイルへ直接書き、そのコードをGitリポジトリや共有フォルダへ置いてしまうことがあります。
APIキーが漏えいすると、第三者からモデルを利用され、想定外の費用やログ調査、キー交換が必要になる可能性があります。
本番環境ではMicrosoft Entra IDとマネージドIDを優先し、APIキーが必要な場合はKey Vaultなどへ分離します。
また、PoCコードをそのまま本番へ流用する可能性を考え、認証部分と業務ロジックを最初から分離しておくことも重要です。
Globalデプロイとデータ処理場所要件の不整合
「AzureリソースをJapan Eastに作成したため、推論処理も必ず日本国内で行われる」と判断するのは適切ではありません。
Global、Data Zone、Regionalでは、推論処理を実行できる地理的範囲が異なります。Globalでは、対象モデルを提供するAzureリージョンへ処理がルーティングされる可能性があります。
この違いをPoC段階で確認していないと、技術検証は成功したものの、本番直前の法務・情報セキュリティ審査で利用を認められない可能性があります。
対策は、「Azureリソース所在地」「データ保存場所」「推論処理場所」を別々に確認することです。必要に応じてData ZoneやRegionalを検討します。
TPM・RPM・トークンコスト未設計による429・予算超過
少人数のPoCでは問題なく動いていても、利用者を増やした途端に429エラーが発生する場合があります。
Azure OpenAIではTPM・RPMなどのレート制限があります。さらに、入力・出力のトークン量は費用にも影響します。
特に、必要以上に長いプロンプトや大量の参考文書を毎回入力すると、1処理あたりのトークン量が増えます。利用者が100人、1,000人へ増えると、PoCでは小さかった差が月額費用へ大きく影響する可能性があります。
対策として、本番化前に次の項目を計測します。
- 代表的な同時利用数での429発生率
- 1リクエストあたりの入力・出力トークン量
- 1処理あたりのAI費用
- 平均・上位パーセンタイルの応答時間
- リトライ発生回数
そのうえで、TPM割り当て、リトライ・バックオフ、モデルの使い分け、入力文の短縮、Budget・監視などを組み合わせます。
Azure OpenAIのStandard系では入力・出力トークンなどに応じて料金が発生します。ProvisionedやBatchでは料金構造が異なるため、公開時点のAzure公式料金を確認してください。
| 失敗要因 | 主な症状 | 主なリスク | 対策 | 確認担当 |
|---|---|---|---|---|
| 旧手順・旧SDKの参照 | UIやコードが公式情報と一致しない | 開発遅延・終了APIの採用 | ポータル名、SDK、API、更新日を確認 | 開発・Azure担当 |
| モデル・リージョン・クオータの後確認 | 希望モデルをデプロイできない | PoC遅延・設計変更 | モデル→方式→リージョン→クオータ→所在地を事前確認 | Azure担当・セキュリティ |
| APIキーのコード埋め込み | Git等へキーが残る | 不正利用・費用発生 | Entra ID/マネージドID、Key Vault | 開発・セキュリティ |
| Globalと所在地要件の不整合 | 本番審査で処理場所が問題化 | 本番化停止 | 保存場所と推論場所を分けて確認 | セキュリティ・法務 |
| TPM・RPM・コストの未設計 | 429、応答遅延、予算超過 | サービス停止・費用増 | 負荷試験、TPM、バックオフ、モデル使い分け、監視 | 開発・FinOps |
Azure OpenAI Serviceの本番導入を判断する基準
PoCでモデルから回答が返っただけでは、本番導入の判断材料として十分ではありません。
本番化では、業務品質・速度・費用・セキュリティ・運用体制をまとめて評価することが重要です。1つでも重大な条件を満たせなければ、モデルが技術的に動いていても本番利用には適しません。
業務品質・処理速度・コストの同時評価
PoC開始前に、現在の業務を数値化しておきます。
たとえば、1件の資料作成に60分かかっている場合、Azure OpenAI導入後にAI処理が5分で終わっても、人間による確認・修正に50分かかれば、業務全体では十分な改善とはいえません。
PoCでは次のような指標を測定します。
- 業務担当者による合格率・正答率
- 処理時間・応答時間
- 1件あたりのトークン量・AI費用
- 429などのエラー率
- Guardrailsによる拒否率
- 再生成率
- 人によるレビュー・修正時間
重要なのは、AI単体の性能ではなく、「AI出力+人間の確認」を含めた業務全体の時間と品質で比較することです。
KDDIの事例でも、情報収集という具体的な業務時間を基準として導入効果を測定しています。PoC前のBeforeを計測していなければ、AI導入後の改善幅も説明できません。
セキュリティ・運用責任・費用管理を含む本番化判断
技術評価を通過した後は、本番運用の条件を確認します。
少なくとも次の項目が決まっている状態を目指します。
- 入力可能・禁止データの分類
- Microsoft Entra IDとRBAC
- ネットワーク構成
- アプリ・AI側のログ管理
- Guardrailsの確認
- モデル・SDK更新時の再評価担当
- 429や障害発生時の対応担当
- 利用量・予算の管理担当
モデルを変更した場合に同じ評価データで再テストできるよう、PoCで使用したテストケースも保存します。一度の検証だけで永続的に利用可能と判断せず、モデルやAPI更新時に再評価できる仕組みを残します。
最終的には、次の3段階で判断すると整理しやすくなります。
- Go:業務効果があり、品質・費用・セキュリティ・運用条件も満たす
- Conditional Go:一部条件を改善すれば本番化できる
- No-Go:費用対効果や安全要件など、重要条件を満たせない
PoCで「モデルが動いた」ことはスタート地点です。本番化の判断では、半年後・1年後も安全かつ継続的に運用できるかまで確認します。
AI導入支援は「フリーコンサルタント.jp」へご相談ください

Azure OpenAI Serviceは、モデルを動かすだけであれば短期間で検証できます。一方、業務要件の整理、PoC設計、Azureアーキテクチャ、セキュリティ、本番化、効果測定まで進めるには複数領域の知識が必要です。
たとえば、「Azureの基盤担当者はいるが生成AIの評価経験がない」「AI担当者はいるがAzureのセキュリティ設計を担える人材がいない」「PoCはできるが全社展開を推進するPMが不足している」といったケースでは、外部のプロ人材を活用する方法があります。
Azure OpenAI Service導入で外部プロ人材を活用する場面
必要な専門性は、導入フェーズによって変わります。
構想段階では、対象業務と生成AIの適用範囲を整理するAI・DX人材が必要です。
PoCでは、モデル評価、API・RAGなどの技術検証、KPI設定を設計できる人材が重要になります。
本番化では、Azureアーキテクチャ、セキュリティ、データ、ネットワークなどの専門性が必要です。さらに、関係部門が増える全社導入ではPM・PMOの役割も大きくなります。
外部人材を利用する場合も、すべてを外部へ任せるのではなく、成果物と終了条件を事前に定義することが重要です。PoCの評価方法、設計判断、運用手順などを社内へ残すことで、外部人材の参画終了後も自社で継続できる体制を作ります。
まとめ
Azure OpenAI Serviceを初めて利用する場合は、まずMicrosoft Foundryとの現在の関係を理解したうえで、Azureサブスクリプション・権限→Foundryリソース・プロジェクト→モデル・リージョン→デプロイ→Playground→認証→API的順に進めると整理しやすくなります。
API実装では、現在のv1 APIと標準OpenAI SDKを基準にし、検索で見つけた旧SDKや日付形式のapi-versionを前提とするコードをそのまま利用しないことが重要です。
PoCではAPIキーを利用して短期間で動作を確認できますが、本番環境ではMicrosoft Entra ID・マネージドID、データ処理場所、Guardrails、クオータ、コストまで含めて設計する必要があります。
また、Azure OpenAI Serviceの導入可否は「AIが回答できたか」だけでは判断できません。業務品質・速度・費用・セキュリティ・運用体制の5点をPoCで測定し、Go/Conditional Go/No-Goを決めることが、本番導入での手戻りを減らすポイントです。
自社だけでAI、Azure、セキュリティ、プロジェクト推進の専門性をそろえることが難しい場合は、不足するフェーズだけ外部のプロ人材を活用する方法も選択肢になります。
※本稿は2026年8月7日時点のMicrosoft公式情報を基準にしています。Microsoft Foundry、モデル提供状況、リージョン、クオータ、料金、API・SDKは更新頻度が高いため、公開・更新時には最新の一次情報を再確認してください。