社内に蓄積された膨大なデータを生成AIで活用する手段として、RAG(Retrieval Augmented Generation:検索拡張生成)への注目が高まっています。
本記事では、RAGの基本的な構築手順から、回答精度を向上させるためのチューニング方法まで詳しく解説します。


RAG(検索拡張生成)とは?
RAG(Retrieval-Augmented Generation)とは「検索(Retrieval)」と「生成(Generation)」を組み合わせた生成AIの技術です。
一般的なLLM(大規模言語モデル)は、事前学習した膨大なデータをもとに文章を生成します。ただし、自社独自の最新情報や社内ルールまでは把握していないため、社内マニュアル、業務資料、過去の問い合わせ履歴などを正確に回答へ反映することは困難でした。
RAGでは、LLMが回答を生成する前に外部データベースから関連する情報を検索します。そして、検索によって取得した自社独自のデータをプロンプトに組み込み、その情報をもとにLLMが回答を生成する仕組みです。これにより、通常のLLM単体では対応が難しかった「自社固有の質問」への回答が可能になりました。
また、参照元となる情報を限定できるため、LLMが事実とは異なる内容を生成するハルシネーション(誤った回答)の抑制にもつながります。さらに、社内データをモデル自体の学習に利用するのではなく、必要な情報だけを検索して利用する仕組みであるため、機密情報を保護しながら生成AIを業務活用できる点も大きな特徴です。
こうしたメリットから、RAGは社内ナレッジ検索、カスタマーサポート、営業支援、問い合わせ対応など、さまざまな業務領域で導入が進んでいます。
RAGと従来のLLMとの違い
RAGと従来のLLMの決定的な違いは「回答を作成する際に、外部の最新情報や独自データを検索して参照するかどうか」にあります。
従来のLLMは、学習時に取り込んだ膨大なデータをもとに回答を生成します。学習時点以降に発生した情報や企業内だけで共有されているマニュアル・業務資料などは、基本的に把握していません。
一方、RAGはLLMそのものを再学習させるのではなく、回答前に必要な情報を外部データベースから検索し、その内容をもとに回答を生成します。

モデルを作り直す必要がなく、比較的低コストで自社向けの生成AI環境を構築できるのが特徴です。
その他にも、以下のような違いがあります。
| 項目 | 従来のLLM | RAG |
|---|---|---|
| 情報の参照元 | 学習時に蓄積された内部知識のみ | 内部知識+外部DB・社内文書・Web検索 |
| 最新情報への対応 | 学習カットオフ時点までのデータのみ | リアルタイム・最新情報を即座に反映可能 |
| 社内・独自データ | 未学習のデータには回答できない | 固有のドキュメント(マニュアル等)を参照可能 |
| ハルシネーション(誤情報) | 知らないことも「それっぽく」捏造しやすい | 検索した事実に基づいて答えるため大幅に減少 |
| 回答の根拠(出典) | 情報源の特定が困難 | 「どの文書のどこを見たか」根拠を提示できる |
| 知識の更新コスト | モデルの再学習やファインチューニングが必要(高コスト) | 参照元のファイルを更新・追加するだけ(低コスト) |
従来のLLMが「幅広い一般知識をもとに文章を生成するAI」であるのに対し、RAGは「自社に必要な情報を検索し、その根拠をもとに回答できるAI」です。社内ナレッジの活用や業務効率化を目的にしたいのであれば、情報の正確性や更新性を維持しやすいRAGが有効な選択肢となると考えられます。
RAG構築が求められている背景
近年多くの企業でRAGの導入が進んでいる主な理由は「社内に蓄積された膨大な情報を有効活用したい」というニーズです。
企業には、業務マニュアル、社内規定、過去の問い合わせ対応履歴、営業資料、日報など、業務改善につながる貴重なデータが数多く存在しています。しかし、大量の情報を適切に整理・検索できる仕組みがないと、必要な情報をすぐに取り出せません。
結果として、情報が活用されないまま、長期間眠っているケースがあるのも事実です。
ChatGPTなどの汎用生成AIサービスも注目を集めていますが、AIを業務利用する場合、社外秘情報や顧客情報を外部サービスへ入力することによる「情報漏えいリスク」が課題となります。機密性の高いデータを扱う企業では、セキュリティ面からそもそも社内情報をそのまま外部AIへ入力しないよう、ルールが厳格になっていることも少なくありません。
また、従来のLLM単体では、学習していない情報について質問された際に事実とは異なる内容を「もっともらしい回答」として生成するハルシネーションが発生しがちでした。
一方、RAGは社内に存在する正確なドキュメントを検索し、その情報を根拠として回答を生成します。回答の正確性や信頼性を高めることができ、業務で安心して利用できる生成AI環境を実現できると考えられます。
その結果、RAGは社内に眠る知識資産を有効活用すると同時に、セキュリティや回答精度などの「生成AI導入リスク」を解決する手段として、多くの企業から注目されるようになりました。
RAGの活用シーン例3つ
RAGは、社内に蓄積された情報を検索し、生成AIによる回答と組み合わせられることから、さまざまな業務領域で活用されています。
①社内ヘルプデスク
人事・総務・ITサポート部門には「パスワードのリセット方法を知りたい」「経費精算の締め日はいつか」「就業規則のどの部分を確認すればよいか」など、日々多くの問い合わせが寄せられます。
同じような質問が繰り返し届くケースも多く、担当者が都度対応すると大きな業務負担になってしまうと考えられます。
RAGを活用すれば、社内規程、各種申請マニュアル、過去の問い合わせ履歴などをAIに参照させ、社員からの質問に自動回答する仕組みを構築できます。具体的には、社内ドキュメントをRAGへ登録してSlackやMicrosoft Teamsなどのチャットツールと連携することで、普段利用しているコミュニケーション環境から簡単に質問することが可能です。
バックオフィス部門の問い合わせ対応にかかる時間を大幅に削減できるだけでなく、社員は担当部署へ確認することなく、必要な情報を24時間365日すぐに取得できるようになります。業務の停滞や確認待ちによるストレスの軽減にもつながり、どの社員にとっても利点のある施策となると考えられます。
②営業ナレッジ活用
営業活動では、過去の成功事例、提案書、見積データ、製品スペック、競合比較資料など、成果につながる多くの情報が日々蓄積されています。しかし、資料が社内に分散している場合、必要な情報を探し出すだけで時間がかかり、担当者によって活用できる知識に差が生まれてしまうこともあります。結果的に、業務が属人化したり、担当者ごとのスキル差が生じたりすることになりかねません。
一方、RAGを導入すれば、これまで個人や一部のチームに蓄積されていた営業ナレッジを横断的に検索し、誰でも必要な情報をすぐに取り出せる環境を構築できます。例えば「〇〇業界で成果につながった提案パターンは?」「競合A社と比較された際に訴求すべき自社の強みは?」という質問を入力すると、RAGが膨大な過去資料の中から関連する情報を抽出して要点を整理・回答します。
生産性の向上だけでなく、提案書作成や商談準備にかかる時間を短縮でき、営業活動のスピード向上につながると考えられます。
また、トップ営業担当者が持つ成功事例や提案ノウハウをデータ化することで、経験の浅い社員でも質の高い提案を行えることもポイントです。属人的だった営業スキルを組織全体で共有できるため、営業力の底上げや提案品質の標準化にも貢献します。
③保守・現場作業支援
製造業の工場やフィールドエンジニアなどの現場作業では、製品の保守・修理対応で数百ページに及ぶ製品マニュアル、技術資料、過去の修理履歴など、膨大な情報の中から必要な情報を迅速に探し出す必要があります。しかし、トラブルが発生する度に該当箇所を手作業で探すのは時間がかかり、対応の遅れにつながってしまうこともあります。
RAGを導入すると、エラーコードや発生している症状などを入力するだけで、AIが関連するマニュアルや過去の対応事例を検索してくれます。そのうえで、必要な復旧手順や確認すべき部品情報も提示してもらえるため、トラブルの原因や対処法にすぐにアクセス可能です。
例えば「装置にエラーコード〇〇が表示された」「特定の部品が正常に動作しない」という問い合わせに対して、過去の修理ログや技術資料をもとに、確認すべきポイントや対応手順をリアルタイムで提供できます。
トラブル発生時のダウンタイム(作業停止時間)を最小限に抑え、現場対応のスピード向上を目指す企業にもおすすめです。
また、これまでベテラン技術者の経験や勘に頼っていたトラブル対応ノウハウをデータ化することで、経験の浅い作業員でも一定水準の初期対応が可能になります。熟練者の知識を組織全体で共有できるため、人材育成や技術継承の課題解決にも貢献すると考えられます。
RAG構築における代表的な4つの環境・方法
RAGを構築する方法は、自社の技術力、利用目的、セキュリティ要件、運用体制によって大きく異なります。手軽に始められるクラウドサービスの活用から、自社環境に合わせて細かくカスタマイズできるフルスクラッチ開発まで、さまざまな選択肢があります。
| 比較項目 | Python開発 | クラウド構築 | ローカル・無料ツール | SaaS・ノーコード |
|---|---|---|---|---|
| 特徴 | 自由度が高い | 運用・拡張しやすい | 自社環境で検証できる | 手軽に導入できる |
| メリット | 細かな調整が可能 | セキュリティ・拡張性が高い | 低コスト・外部送信不要 | 開発知識が少なくても使える |
| デメリット | 高い開発スキルが必要 | 継続コストがかかる | 性能・運用に制約がある | カスタマイズ性が低い |
| 向いているケース | 高精度・独自要件 | 本番運用・大規模利用 | PoC・小規模検証 | 初期検証・スモールスタート |
①Pythonによるカスタム開発
Pythonを用いたカスタム開発は、RAGの構成要素を自由に組み合わせ、自社の業務要件に合わせて柔軟に設計できる方法です。
具体的には、RAG開発で広く利用されている「LangChain」や「LlamaIndex」などのオープンソースのフレームワークを活用し、API経由でLLMやベクトルデータベースと接続します。
主なメリットとデメリットは、以下の通りです。
メリット
- 自社の業務要件に合わせて柔軟なカスタマイズが可能
- 検索精度向上のための細かなチューニングを実施できる
- 独自機能の追加や他システムとの連携がしやすい
デメリット
- Pythonなどのプログラミング知識が必要
- LLMやデータベース、クラウド環境に関する技術的な知識が求められる
- 開発・保守を行う社内人材や体制の確保が必要
データの検索方法、回答生成のルール、ユーザー権限ごとのアクセス制御などを細かく調整できるため、高い回答精度が求められる業務システムや複雑な要件を持つ企業に適しています。
②AWSなどのクラウドを活用した構築
AWSなど、クラウド上に用意されたAIサービス、データベース、セキュリティ機能などを組み合わせることで、インフラを一から構築することなく企業向けのRAGシステムを効率的に導入できます。
例えば、AWSでは生成AIサービス、ストレージ、検索基盤など、RAGに必要な機能を組み合わせて利用することが可能です。
そのため、自社でサーバーを用意して環境を構築する場合と比べ、初期構築にかかる時間や運用負荷を抑えられます。
メリット
- サーバーやインフラ管理の負担を軽減できる
- クラウド事業者が提供する強固なセキュリティ機能を利用できる
- アクセス権限管理やデータ保護の仕組みを導入しやすい
- 利用規模に応じてリソースを柔軟に拡張できる
デメリット
- クラウドサービスの利用料金が継続的に発生する
- 各サービス固有の仕様や制約があり、自由度に限界がある
- 高度な独自チューニングには追加開発が必要になる
企業利用では「誰がどの情報へアクセスできるか」を管理することが重要です。クラウド環境であればユーザー認証や権限管理の仕組みを活用できるため、部署ごとに閲覧できる情報を制御するなど、安全性を考慮したRAGシステムを構築しやすくなります。
クラウド型RAGは「高度な独自カスタマイズよりもセキュリティや安定した運用を重視したい企業」に適した構築方法といえます。
③ローカル環境や無料ツールを使用した検証用構築
ローカル環境や無料のオープンソースツールを活用して、RAGの検証用システムを構築する方法です。
例えば、Ollamaなどのツールを利用して自社のPC上でLlama 3などのオープンソースLLMを動作させ、無料で利用できるRAG関連ツールと組み合わせてプロトタイプを作成します。
外部のクラウドサービスを利用することなく、自社環境内でAIモデルやデータを扱えるため、まずは小規模なPoC(概念実証)を実施したい企業に適しています。
メリット
- ランニングコストを抑えてRAGの検証ができる
- 社内データを外部サービスへ送信しないため、情報漏えいリスクを低減できる
- 小規模なPoCや技術検証の初期段階に適している
- 自社でRAGの仕組みや性能を確認しながら開発を進められる
デメリット
- 高性能なGPUを搭載したPCやサーバーが必要になる
- 環境構築やトラブル対応に技術的な知識が求められる
- 大規模なユーザー利用や高負荷な本番運用には向いていない
- モデルやツールの管理を自社で行う必要がある
ローカル環境でのRAG構築は、いきなり本番システムを導入する前に「どの程度の回答精度が出るのか」「自社データを活用できるのか」を確認する用途に向いています。特に、機密性の高いデータを扱う企業では、外部環境へ情報を送信せずに検証できる点が大きなメリットです。
一方で、個人のPCや限られたサーバー環境では処理能力に限界があるため、利用人数が増えたり大量のデータを扱ったりする段階では、クラウド環境や専用インフラへの移行を検討する必要があります。ローカル環境での構築は「本格導入前の技術検証」や「小規模な社内利用を試したい企業」に適した方法と考えられます。
④SaaS・ノーコードRAGツール
SaaSやノーコード型のRAGツールを活用する方法は、開発スキルや専門知識が少ない企業でも導入しやすいのが特徴です。
近年では、RAG機能を搭載したSaaSサービスや、ドラッグ&ドロップなどの操作でAIチャットボットを作成できるノーコードツールが登場しました。例えば、DifyやAzure OpenAI+AI Searchのようなサービスを利用すれば、複雑なプログラミングを行わなくても、社内文書を登録してAIに質問できる環境を短期間で構築できます。
メリット
- プログラミング知識がなくても導入しやすい
- 数日程度の短期間でRAG環境を構築できる
- 開発コストや初期導入費用を抑えられる
- 小規模なPoCや社内検証を始めやすい
デメリット
- 検索ロジックや回答生成処理など細かなカスタマイズに限界がある
- 独自システムとの高度な連携が難しい場合がある
- 大規模利用や特殊な業務要件では機能不足になる可能性がある
SaaS・ノーコード型RAGツールは「高度な開発環境を整える前に、まず生成AIの効果を確認したい」という企業に適しています。一方で、利用範囲が広がってより高い回答精度や複雑な業務連携が必要になった場合は、カスタム開発やクラウド環境を利用した本格的なRAG構築へ移行することが望ましいと考えられます。
そのため、最初から大規模なシステムを構築するのではなく、SaaSやノーコードツールで効果検証を行い、必要に応じて段階的に拡張していく進め方も有効です。
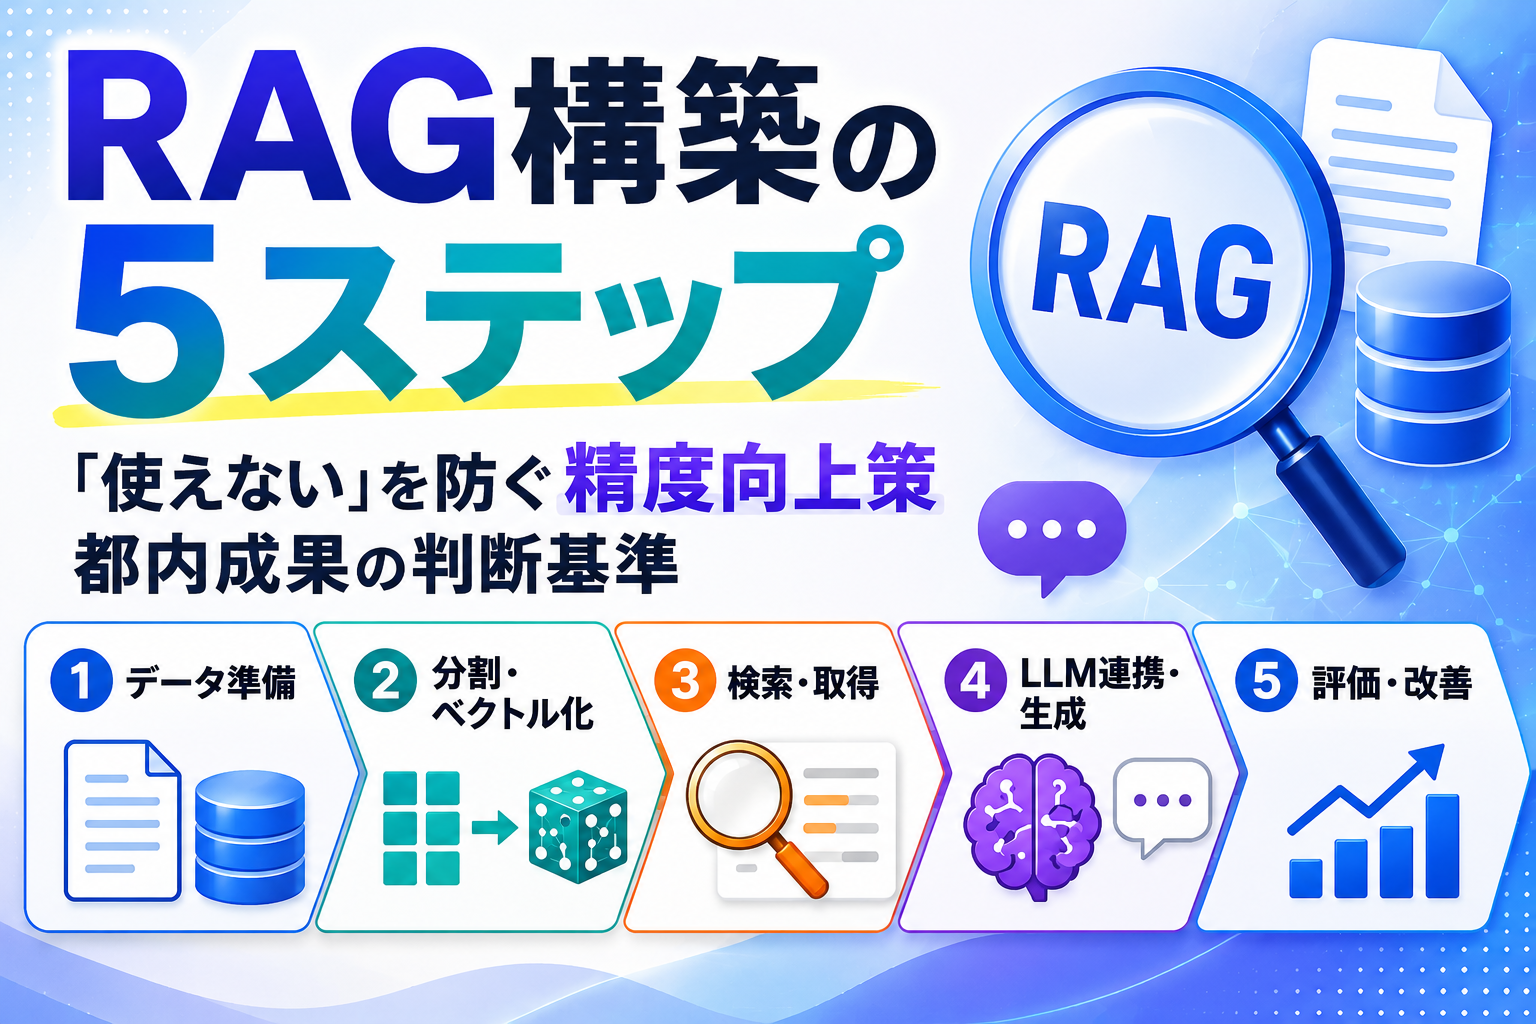
RAGを構築する5つの手順
RAGは「どのデータを参照させるか」「どのように検索するか」によって回答品質が大きく変わります。構築後に「期待した回答が得られない」「現場で使われない」という事態になることを防ぐためにも、初期設計の段階から適切な手順で進めましょう。
- 事前準備と活用データの整理・選定
- データの前処理(テキスト抽出・チャンク分割)
- テキストデータのベクトル化と格納
- 検索処理とプロンプトの設計
- LLMによる回答生成と精度評価
①事前準備と活用データの整理・選定
RAGは、登録された資料やデータを検索し、その内容をもとに回答を生成する仕組みです。参照元となるデータが不正確であれば、どれだけ高性能なLLMを利用しても正しい回答を得ることはできません。
例えば、社内マニュアルに古いルールが残っている、同じ内容なのに部署ごとに異なる表現が使われている、複数の資料で異なる情報が記載されているという状態では、AIがどの情報を正しいものとして扱うべきか判断できません。その結果、誤った回答や曖昧な回答につながる可能性があります。
そのため、RAG構築の最初の段階では、参照させるデータの整理・選定が重要です。
具体的には、以下のような作業を行います。
- RAGに登録する対象データの選定(PDF、Word、Markdown、Excel・スプレッドシートなど)
- 古いマニュアルや不要な資料の削除
- 最新版のドキュメントへの更新
- 表記揺れや重複情報の整理
- 部署ごとに分散しているナレッジの集約
- ファイル形式や記載ルールの統一
「どのような情報を参照させるか」によって性能が決まるからこそ、システム構築前のデータ整備を行い、回答精度を高める重要な土台を作りましょう。
②データの前処理(テキスト抽出・チャンク分割)
データをRAGに登録する前には、AIが必要な情報を正確に検索するための「前処理」が必要です。
RAGは、登録されたデータの中から質問に関連する情報を探し出して回答を生成します。しかし、元の文書に不要な情報や形式の乱れが含まれていると、AIが検索対象を正しく判断できず、回答精度の低下につながるので注意しましょう。
例えば、以下のような情報は検索時のノイズになる場合があります。
- 全ページに表示されるページ番号
- 会社名や部署名などの固定ヘッダー
- 不要なフッター情報
- 意味を持たない改行や記号
- 重複して記載された文章
まずは、ドキュメントから上記の情報を取り除く「データクレンジング」を行いましょう。不要な情報を削除すると、本当に必要な内容をAIが検索しやすくなります。
また、余計な文字情報を減らすことでLLMが処理するトークン量を削減でき、利用コストの抑制にもつながるのがポイントです。
さらに、長文ドキュメントを適切なサイズに分割する「チャンク分割」も進めましょう。
例えば、数百ページあるマニュアルを1つのデータとして登録しても、AIはその中から必要な情報を効率的に探し出すことが困難です。そこで、文章を意味のまとまりごとに分割し、検索しやすい単位(チャンク)に整理します。適切なチャンク分割を行うことで、ユーザーの質問に関連性の高い部分だけを正確に取得できるようになり、RAGの回答精度向上を実現可能です。
③テキストデータのベクトル化と格納
RAGでは、ユーザーから質問を受けた際に膨大なデータの中から関連性の高い情報を検索する必要があります。そのため、文章の「意味」や「文脈の近さ」をもとに検索できる仕組みが必要です。
具体的には、分割したチャンクデータを、Embedding Model(埋め込みモデル)によって多次元の数値データである「ベクトル」に変換し、ベクトル情報をPinecone、Chroma、pgvectorなどのベクトルデータベースへ保存します。ベクトル化することで、AIは単語の完全一致ではなく「文章が持つ意味の近さ」をもとに情報を探せるようになります。
また、ベクトルデータベースは、大量のデータから類似した情報を高速で検索することに特化しています。
数万〜数百万件規模のドキュメントを扱う場合でも、質問に関連する情報を短時間で抽出できるのがメリットです。
④検索処理とプロンプトの設計
ユーザーから入力された質問に対して、どの情報を検索し、どのような形でLLMへ渡すかを設計することが重要です。LLMは、指示が曖昧な場合、検索結果に含まれる情報だけではなく、自身が持つ学習済みの知識をもとに回答を補完しようとすることがあります。その結果、事実とは異なる内容を生成するハルシネーション(誤情報)が発生しやすくなるので注意しましょう。
具体的には、ユーザーの質問をベクトル化し、ベクトルデータベースに保存された情報の中から関連性の高いドキュメントを検索する仕組みを構築し、検索によって取得した上位のドキュメントを「参考情報」としてプロンプトに組み込み、LLMへ回答を生成させます。
このとき、以下のようなルールをプロンプトに設定しておくことで、出力精度を高めることが可能です。
- 「以下の参考資料だけを根拠に回答してください」
- 「資料内に情報がない場合は、推測せず『情報がありません』と回答してください」
- 「回答には参照元の資料名を提示してください」
「ユーザーの質問」+「検索で取得した正確な資料」+「回答ルール」をセットでLLMへ渡すと、AIが不要な推測を行うリスクを抑えられます。LLMへの指示方法まで適切に設計し、より信頼性の高いRAGシステムを実現しましょう。
⑤LLMによる回答生成と精度評価
最後の工程では、設計したRAGシステムに実際に質問を入力し、LLMが生成する回答の精度を評価します。検索によって取得した情報をもとにLLMへプロンプトを入力し、回答が意図した内容になっているか確認しましょう。
評価を行わずにRAGを運用すると、誤った情報をユーザーへ提供してしまうリスクも否定できません。導入前には実際の業務で想定される質問(テストクエリ)を用意し、回答内容を確認することが重要です。
また、RAGASや人によるテスト・レビューを活用して、回答の正確性や信頼性を検証することで、どの部分を改善すべきかが明確になります。
RAGASとは、RAGの性能を自動的にテスト・評価するオープンソースのライブラリです。
なお、回答の正確性や信頼性が低い場合は、主に以下のどちらかが原因です。
| エラー | 原因 |
|---|---|
| 検索処理の失敗 | 質問に関連する正しい資料を取得できていない |
| 回答生成処理の失敗 | 正しい資料を取得できているものの、LLMが内容を正しく解釈できていない |
必要な情報が含まれる資料を検索できていない場合、チャンク分割や検索ロジックの見直しが必要です。一方で、適切な資料を取得できているにもかかわらず誤った回答を生成する場合は、プロンプト設計やLLM側の設定を見直しましょう。
また、精度評価の結果、目標とする回答品質に届かない場合は、修正を繰り返しながら最適な精度へ近づけることがポイントです。
RAGが「使えない」を防ぐ精度向上の3つのポイント
RAGは社内データを活用できる強力な仕組みですが、構築しただけで必ず高精度な回答が得られるわけではありません。「質問に対して関係のない資料を検索してしまう」「回答内容に不足や誤りがある」「現場で期待したように使えない」など、課題が発生するケースもあります。
次項からは、RAGを実務で活用できるレベルまで高め「使えないAI」にしないための3つの精度向上ポイントを解説します。
- 「リランカー(再順位付け)」の導入による検索精度の底上げ
- 参照ソースの明示
- メタデータの付与とハルシネーションを抑制するプロンプト設計
①「リランカー(再順位付け)」の導入による検索精度の底上げ
通常のRAGでは、ベクトル検索によって質問と意味の近いドキュメントを抽出します。ただし、関連性の低い情報が検索結果に混ざる場合があります。
そこで有効なのが、検索結果を質問との関連性に応じて並び替える「リランカー」です。
- ベクトル検索で候補ドキュメントを取得
- リランカーで関連性を再評価して順位を調整
例えば「経費精算の申請期限」を質問した場合、経費関連の資料の中から、申請期限が記載された資料を優先してLLMへ渡せます。
特に社内文書が多い企業では、必要な情報を正しく検索できるかが回答精度を左右するため、リランカーの活用が有効です。
②参照ソースの明示
RAGの回答には、参照したドキュメント名やページ、リンクなどをあわせて表示すると、利用者が回答の根拠を確認しやすくなります。
例えば「経費精算の申請期限は毎月〇日です」という回答とともに、「経費精算マニュアル P.12」と表示するイメージです。
参照元を明示すれば、回答内容を利用者自身で確認できるため、誤情報をそのまま業務に利用するリスクを抑えられます。特に人事・法務など、回答の正確性が重要な業務では有効な対策です。
③メタデータの付与とハルシネーションを抑制するプロンプト設計
検索精度を高めるには、ドキュメントに更新日時・部署名・製品名・文書カテゴリなどのメタデータを付与する方法も有効です。
例えば「2025年以降に更新された製品Aの資料のみ」といった条件で検索対象を絞れば、不要な情報を除外しやすくなります。
また、ハルシネーションを抑えるため、システムプロンプトには以下のようなルールを設定します。
- 「提示された資料のみを根拠に回答する」
- 「該当する情報がなければ『わかりません』と回答する」
- 「不確かな情報を推測して補完しない」
検索対象を適切に絞り、回答ルールを明確にすることで、根拠のない回答を抑えやすくなります。
自社でRAG構築を行う際の3つの課題と対策
自社でRAGを構築・運用する際に多くの企業が直面する代表的な3つの課題と、その対策について解説します。
- 生成AIやLLM特有の技術・開発スキルの不足
- 回答精度を検証・チューニングし続ける運用の手間の多さ
- セキュリティ対策と企業情報・機密情報のアクセス制御の壁
①生成AIやLLM特有の技術・開発スキルの不足
RAGを構築する際は、一般的なWebシステム開発とは異なる専門知識が求められます。例えば、LLMの特性を理解したプロンプト設計やEmbedding Modelを用いたベクトル化、ベクトルデータベースの設計・運用、検索精度を高めるチューニングなど、生成AIならではの技術が必要です。
Webアプリケーション開発の経験があるエンジニアでも、生成AIやデータエンジニアリングの知識が不足していると、設計や実装に時間がかかってしまいます。
また、社内だけで知識を習得しながら開発を進めようとすると学習コストが膨らみ、PoCや本番導入までの期間が長期化しやすいので注意しましょう。
対策として有効なのは、PoC(概念実証)から段階的に進める、または外部の専門人材を活用することです。
いきなり大規模なRAGシステムを構築するのではなく、まずはPoCで小規模な検証を行い、技術面や運用面の課題を洗い出しましょう。

②回答精度を検証・チューニングし続ける運用の手間の多さ
RAGは、一度構築すれば終わりというシステムではありません。社内マニュアルの更新、新しい資料の追加、業務フローの変更などに合わせて、参照データは常に変化します。
利用者から寄せられる質問も多様であるため、新しいデータを追加したことで検索結果が変わり、これまで正しく回答できていた質問の精度が低下することも少なくありません。
RAGを実務で安定して運用するには、回答精度を定期的に検証し、検索ロジックやチャンク分割、プロンプトなどを継続的に改善していくことが必要です。しかし、評価用データセットの作成や精度測定、改善内容の検証を人手だけで行うと、大きな運用負荷が発生します。
対策に迷ったときは、評価自動化ツールの導入と運用プロセスの標準化を目指しましょう。
RAGASなどの評価フレームワークを活用し、回答精度を継続的に測定できる仕組みを整えることが有効です。
③セキュリティ対策と企業情報・機密情報のアクセス制御の壁
RAGを企業で運用するうえで、特に重要となるのがセキュリティ対策です。
社内には、人事情報、経営資料、契約書、役員向け資料など、閲覧できる社員が限定される機密情報が数多く存在します。適切なアクセス制御が行われていないと、本来閲覧権限のないユーザーに対してRAGが機密情報を回答してしまうリスクがあるので注意しましょう。
情報漏えいを防ぐためには、ユーザーごとの権限に応じて検索対象を制御する仕組みを実装することが重要です。
例えば、営業部の社員には営業資料のみ、人事部の社員には人事関連資料のみを検索対象とする、などのアクセス制御を行います。
しかし、このような権限管理をRAGへ組み込むには、既存の認証基盤やアクセス権限と連携した設計が求められます。対策として、ID管理基盤(IDaaS)との連携と検索時フィルタリングの実装などを検討しましょう。
RAGでは回答精度だけでなく、「誰にどの情報を回答してよいか」を適切に制御することも重要です。導入後にアクセス制御を追加するのは難しいため、認証基盤との連携や権限設計は、システムの初期設計段階から組み込んでおくことをおすすめします。
RAG構築を内製化するか外部人材を活用するかの検討項目3つ
RAGを導入する際は「自社で構築・運用するべきか」「外部の専門人材やコンサルタントを活用するべきか」という判断も必要です。内製化には自社にノウハウを蓄積できるメリットがある一方で、生成AIやLLMに関する専門知識を持つ人材の確保や育成が欠かせません。
どちらが適しているかは、社内の技術力や人員体制、導入スケジュール、将来的な運用方針によって異なります。自社の状況に合わない進め方を選ぶと、開発期間の長期化や運用負荷の増加につながりかねません。
RAG構築を内製化するか外部人材を活用するか判断する際に、確認しておきたい3つの検討項目を解説します。
①社内に実務経験のあるエンジニアがいるかどうか
RAGを内製化するには、LLM・RAGの実装や検索精度改善まで経験したエンジニアが社内にいるかが重要です。
特に、以下のような経験が求められます。
- チャンク分割やEmbeddingを含むRAGの実装
- ベクトルデータベースの構築・運用
- リランカーなどを使った検索精度の改善
- プロンプトや回答精度の評価・チューニング
こうした知見を持つ人材がいれば内製化しやすい一方、経験が不足している場合や短期間で導入したい場合は、外部の専門人材を活用したほうが効率的です。
また、初期構築だけ外部へ依頼し、運用・改善を社内へ引き継ぐ方法もあります。将来的な内製化を目指す企業にも有効です。
②求める回答精度のレベルが高いかどうか
RAGは用途によって必要な回答精度が異なるため、誤回答をどこまで許容できるかを基準に判断しましょう。社内FAQやマニュアル検索など、人が内容を確認できる用途であれば、標準的なRAGでも対応できる場合があります。
一方、契約書や金融・医療情報など高い正確性が求められる用途では、リランカーなどの高度な検索手法や、RAGASなどを使った継続的な精度評価・改善が必要です。
そのため、専門的なチューニングが必要な場合は、RAG構築の実績を持つ外部人材の活用も検討すると良いと考えられます。
③複雑なインフラ設計を伴うか
RAGを本番運用する際は、LLMだけでなく、認証・権限管理、社内システム連携、セキュリティ、可用性なども含めた設計が必要です。
特に、以下のような要件があると構築難易度が高まります。
- 部署や役職ごとのアクセス制御
- オンプレミス・閉域網での構築
- SharePointやGoogle Driveなどとの連携
- 大規模データの高速検索
- 高可用性や障害対策
マネージドサービスの標準機能で対応できる場合は内製化しやすい一方、複雑なシステム連携や厳格なセキュリティ要件がある場合は、外部の専門エンジニアやコンサルタントを活用したほうが、設計ミスや手戻りを防ぎやすくなります。

RAG構築なら「フリーコンサルタント.jp」へご相談ください
RAGは比較的短期間で構築できるシステムですが、実務で活用できる回答精度を実現するには、データ整備、検索設計、プロンプト設計、継続的なチューニングなど、幅広い専門知識が求められます。中には「PoCまではできたものの回答精度が上がらない」「自社に生成AIやLLMの知見を持つ人材がいない」「短期間でRAGを導入したい」という課題を抱える企業も少なくありません。
「フリーコンサルタント.jp」では、生成AI・LLM・RAGの知見を持つフリーランスのITコンサルタントやAIエンジニアをご紹介しています。
また「まずはPoCだけ依頼したい」「内製化を見据えて技術移転を受けたい」「特定工程のみ支援してほしい」などのご要望にも柔軟に対応できます。
RAG導入を成功させるためには、自社の目的や体制に合った構築方法を選択することが重要です。生成AIの活用を加速させたい方やRAG構築・運用に課題を感じている方は、ぜひ「フリーコンサルタント.jp」へご相談ください。

フリーコンサルタント.jpによる生成AI導入の成功事例3選
次項からは、生成AIの活用によって業務効率化やDX推進を実現した具体的な支援事例を紹介します。
- 大手SIer
- 大手保険代理店
- 大手金融会社
①大手SIer
大手SIer企業では、社内に蓄積されたナレッジや過去資料を収集・分析していましたが、組織が縦割りになっていたことで必要な情報が各部門に分散しており、資料の収集や確認に多くの時間と手間が発生していました。また、生成AIを活用した業務効率化の必要性を感じていたものの、社内に生成AIの技術知識や実装ノウハウを持つ人材が不足しており、現場の要望をどのようにシステムへ落とし込むべきかの判断が難しい状況でした。
そこで、フリーコンサルタント.jpの生成AI領域の知見を持つプロ人材がPMとして参画し、社内担当者と連携しながら、生成AIデジタル社員の企画立案から実装までを支援しました。
具体的には、以下の支援を実施しています。
- 各部門へのヒアリングによる業務課題の整理
- 生成AIで実現可能な業務範囲の検討
- 生成AIデジタル社員の具体的な活用方法の企画立案
- 運用開始後の回答品質や利便性向上に向けた改善活動
現場部門と技術側の橋渡し役としてプロジェクトを推進し、業務で利用できるレベルまで生成AIデジタル社員の開発を進めました。その結果得られた成果は、以下の通りです。
- 現場課題と技術的な実現可能範囲を整理し、最適な活用方法を設計
- 社内ナレッジを横断的に活用できる生成AI環境を構築
- 導入後も継続的な改善を行い、実務で活用できるAIへ成長させた
生成AIデジタル社員の導入により、これまで部門ごとに分散していた社内ナレッジや必要資料を、必要なタイミングですぐに検索・取得できる環境を実現しました。従来は担当者が各部署へ問い合わせたり過去資料を探したりする必要がありましたが、生成AIを活用することで情報収集にかかる時間を大幅に削減しています。その結果、顧客提案に向けた準備や資料作成の効率化につながりました。
②大手保険代理店
大手保険代理店では、Azure OpenAIおよびPythonを活用した生成AIボットのプロトタイプ開発を完了しており、その後は社内利用の拡大および顧客向けサービスとしての展開を目指していました。しかし、プロトタイプを実際の業務で活用できるレベルへ発展させるには、生成AIソリューションの展開戦略、運用体制の整備、社内への浸透施策など、複数の課題がありました。
また、生成AIに関する最新技術のキャッチアップや開発したボットを社内外へ展開するための推進人材が不足していたことから、フリーコンサルタント.jpの生成AI領域に精通したプロ人材が、エバンジェリストとして生成AIソリューションの社内展開・事業化を伴走支援しました。
具体的には、以下の支援を実施しています。
- 生成AIボットの社内活用に向けた展開戦略の策定
- 最新生成AIツール・技術動向の調査および分析
- 顧客向けサービス化に向けた企画・検討支援
- プロパー社員へのスキルトランスファー
技術導入だけに留まることなく、現場で継続的に活用される仕組みづくりを重視し、生成AI活用の定着化を推進しました。
その結果、以下のような成果を生み出しています。
- 開発済みの生成AIボットを実務利用できるサービスへ発展
- 最新技術の調査から実装・事業化まで一貫して支援
- スキルトランスファーにより社内で継続的に生成AI活用できる体制を構築
生成AIボットの活用により問い合わせ対応工数を60%削減し、社員がより付加価値の高い業務へ注力できる環境を構築したのが特徴です。生成AIボットの全社展開を実現し、社員間で発生していたナレッジ共有や問い合わせ対応にかかる時間を大幅に削減しました。
また、社内での活用実績をもとに、顧客向け生成AIサービスの事業化にも着手し、最新の生成AI技術を分析しながら自社ソリューションへの実装を進める体制を整備できました。
③大手金融会社
大手金融会社では、生成AIを活用した業務効率化を推進するため、各事業部門と連携しながら社内での生成AI活用を進めていたものの、生成AIに関する専門知識や要件定義、システム開発までを推進できる人材が不足していました。また、情報収集や営業提案資料の作成など、時間や手間がかかる業務を生成AIで効率化したいというニーズがある一方で、ビジネス側の要望を整理し、実務で利用できる機能へ落とし込める人材も不足していたのです。
そこで、フリーコンサルタント.jpの生成AI領域の知見を持つプロ人材が参画し、各事業部門と連携しながら、現場で活用できる生成AI機能の企画・開発を支援しました。
具体的には、以下の支援を実施しています。
- 生成AI活用に向けた要求整理・要件定義
- 業務課題を解決する生成AI機能の企画立案
- 生成AIシステムへの機能実装支援
- 生成AI活用に関する社員へのナレッジトランスファー
ビジネス側の要望を技術要件へ変換し、アイデア段階だった生成AI活用案を実際の業務で利用できる機能へ発展させました。
その結果、以下のような成果を生み出しています。
- 各事業部門の業務課題をもとに生成AI活用方法を設計
- ビジネス要件を整理し、実務で使える機能へ実装
- PoCによる検証を通じて生成AI活用の可能性を具体化
各事業部門と密にコミュニケーションを取りながら、現場の課題に合わせた生成AI機能の企画・実装を実現しました。
これにより、情報収集や文書作成など、これまで多くの時間を要していた業務を効率化できる環境を構築しています。
また、生成AI活用に関するPoCや実証実験を通じて、企画段階のアイデアを実務レベルで利用できる機能へ発展させることが可能になりました。
まとめ
RAG(検索拡張生成)は、社内マニュアルや業務データなどの独自情報をLLMに参照させることで、生成AIをより実務に活用しやすくする技術です。
ただし、RAGを構築するだけで高精度な回答が得られるわけではありません。読み込ませるデータの整理、適切なチャンク分割、検索精度の向上、プロンプト設計、継続的な評価・改善など、さまざまな工程を最適化することで、初めて「現場で使えるRAG」になると考えられます。
また、RAG導入後に「回答が的外れ」「ハルシネーションが多い」「業務で利用できない」という状態になることを防ぐには、リランカーの活用や参照元の明示など、精度向上のためのチューニングが欠かせません。